ZFS sous Proxmox VE : pourquoi nous l’avons choisi, et ce qu’il coûte
Toutes nos plateformes de virtualisation tournent sous Proxmox VE avec un stockage ZFS. Ce n’est pas une préférence esthétique : c’est un choix qui se justifie par ce qui casse réellement en production, et il a un coût qu’il faut connaître avant de le reproduire.
Le vrai risque n’est pas la panne de disque, c’est la corruption silencieuse
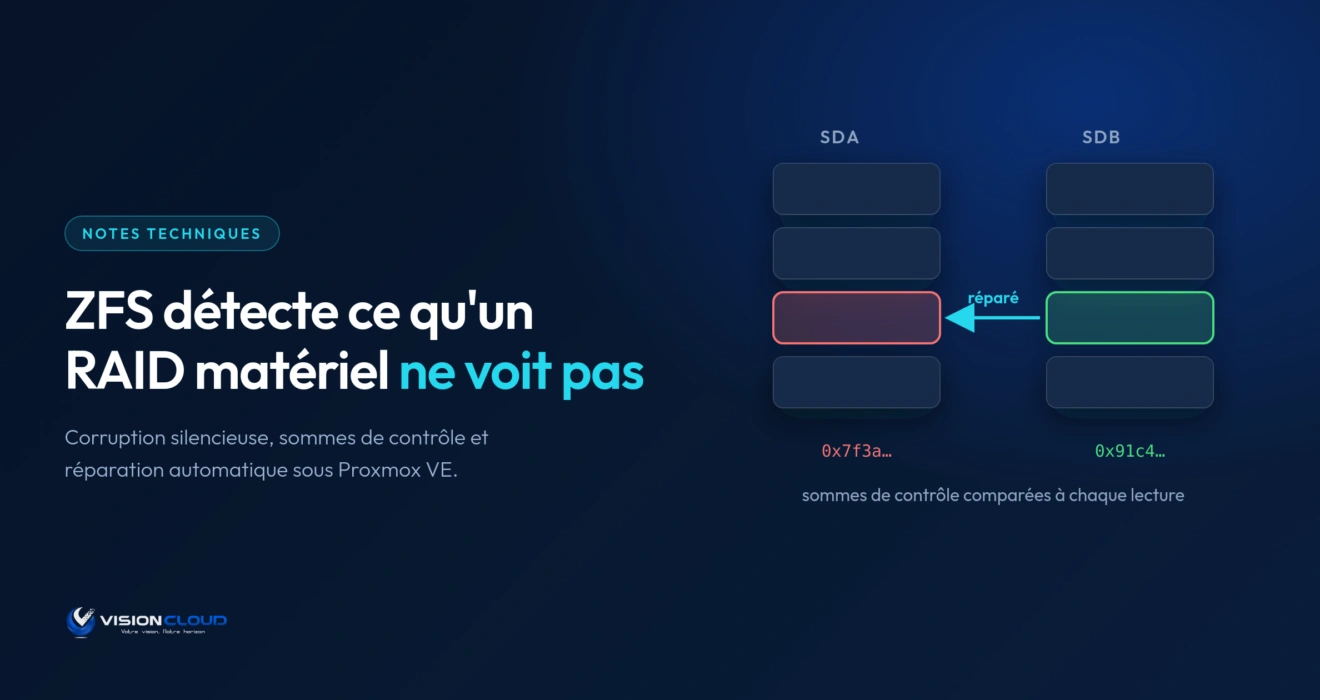
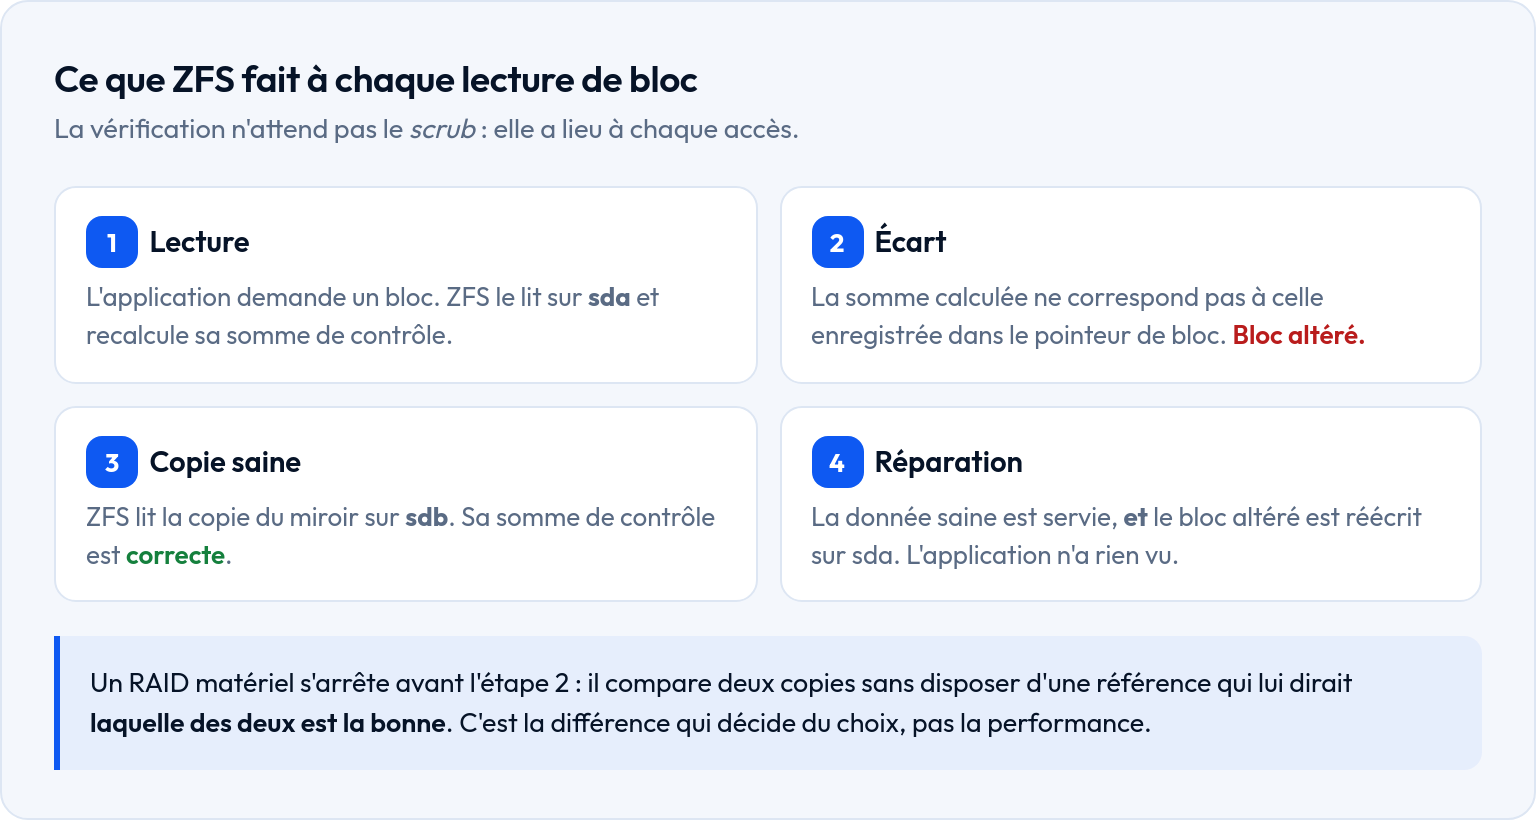
Un disque qui meurt franchement est un incident simple : la grappe le signale, on le remplace. Le cas dangereux est le bloc qui revient altéré sans que rien ne le signale. Un RAID matériel classique ne détecte pas cette situation : il n’a aucun moyen de savoir laquelle des deux copies est la bonne, il ne fait que comparer des blocs.
ZFS calcule une somme de contrôle pour chaque bloc et la vérifie à la lecture. Sur un pool redondant, un bloc altéré est non seulement détecté mais réparé à partir de la copie saine.
Voilà à quoi ressemble la trace d’une réparation sur un hôte réel. Le pool est annoncé ONLINE et sans perte de données, mais deux informations méritent d’être lues : le scrub a réparé 128 Ko, et le disque sdb porte deux erreurs de somme de contrôle à son compteur.
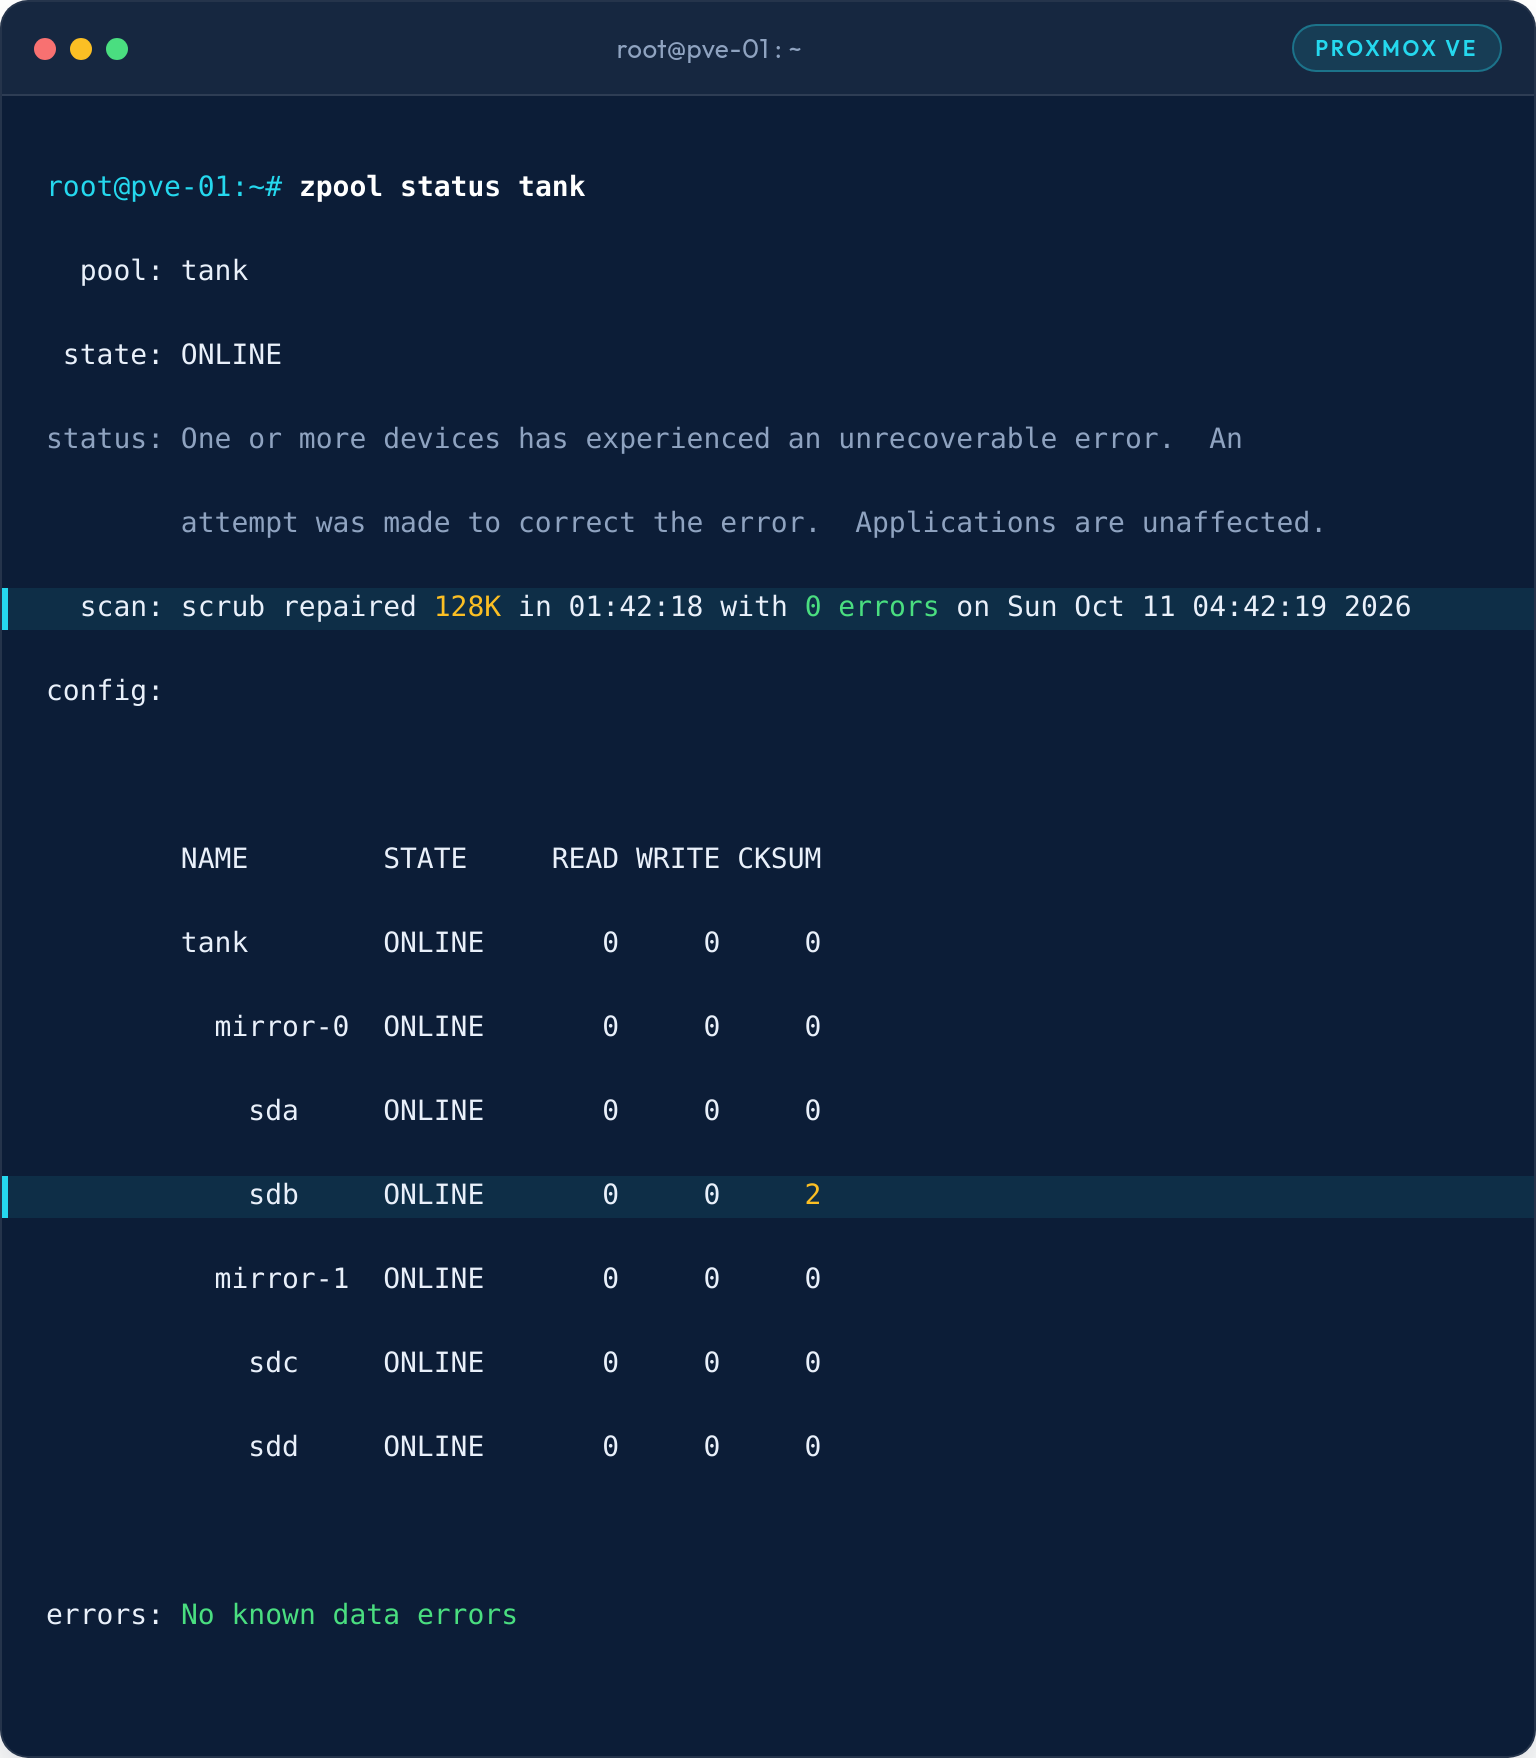
Un compteur CKSUM qui monte n’est pas une alerte de panne : c’est un début d’historique. S’il reste à deux pendant six mois, le disque a eu un mauvais jour. S’il recommence à chaque scrub, on le remplace avant qu’il ne tombe. Pour un hébergeur qui garantit l’intégrité de données qui ne sont pas les siennes, cette visibilité seule justifie l’ensemble.
Le scrub se programme, et il se paie en entrées-sorties
Le scrub relit l’intégralité des données du pool et vérifie chaque somme de contrôle, plutôt que d’attendre qu’un utilisateur ouvre le fichier concerné. Sur Debian, et donc sur Proxmox VE, le paquet zfsutils-linux en programme un par mois sans qu’on ait rien à faire.
Nous gardons ce rythme, mais pas n’importe quand : un scrub sature les disques pendant une à plusieurs heures, et le lancer un mardi à 10 h sur un ERP, c’est transformer une mesure de sûreté en incident de performance. La seule règle qui compte ici est de savoir à quelle heure il tourne et combien de temps il dure sur vos volumes — les deux figurent dans la sortie ci-dessus.
Les instantanés changent la façon de travailler
Parce que ZFS est en copie sur écriture, un instantané ne coûte pratiquement rien à créer et n’occupe que les blocs modifiés ensuite. Le tableau ci-dessous le montre mieux qu’une explication : trois instantanés d’une machine qui référence 85 Go de données, et dont le plus ancien n’occupe réellement que 1,21 Go.
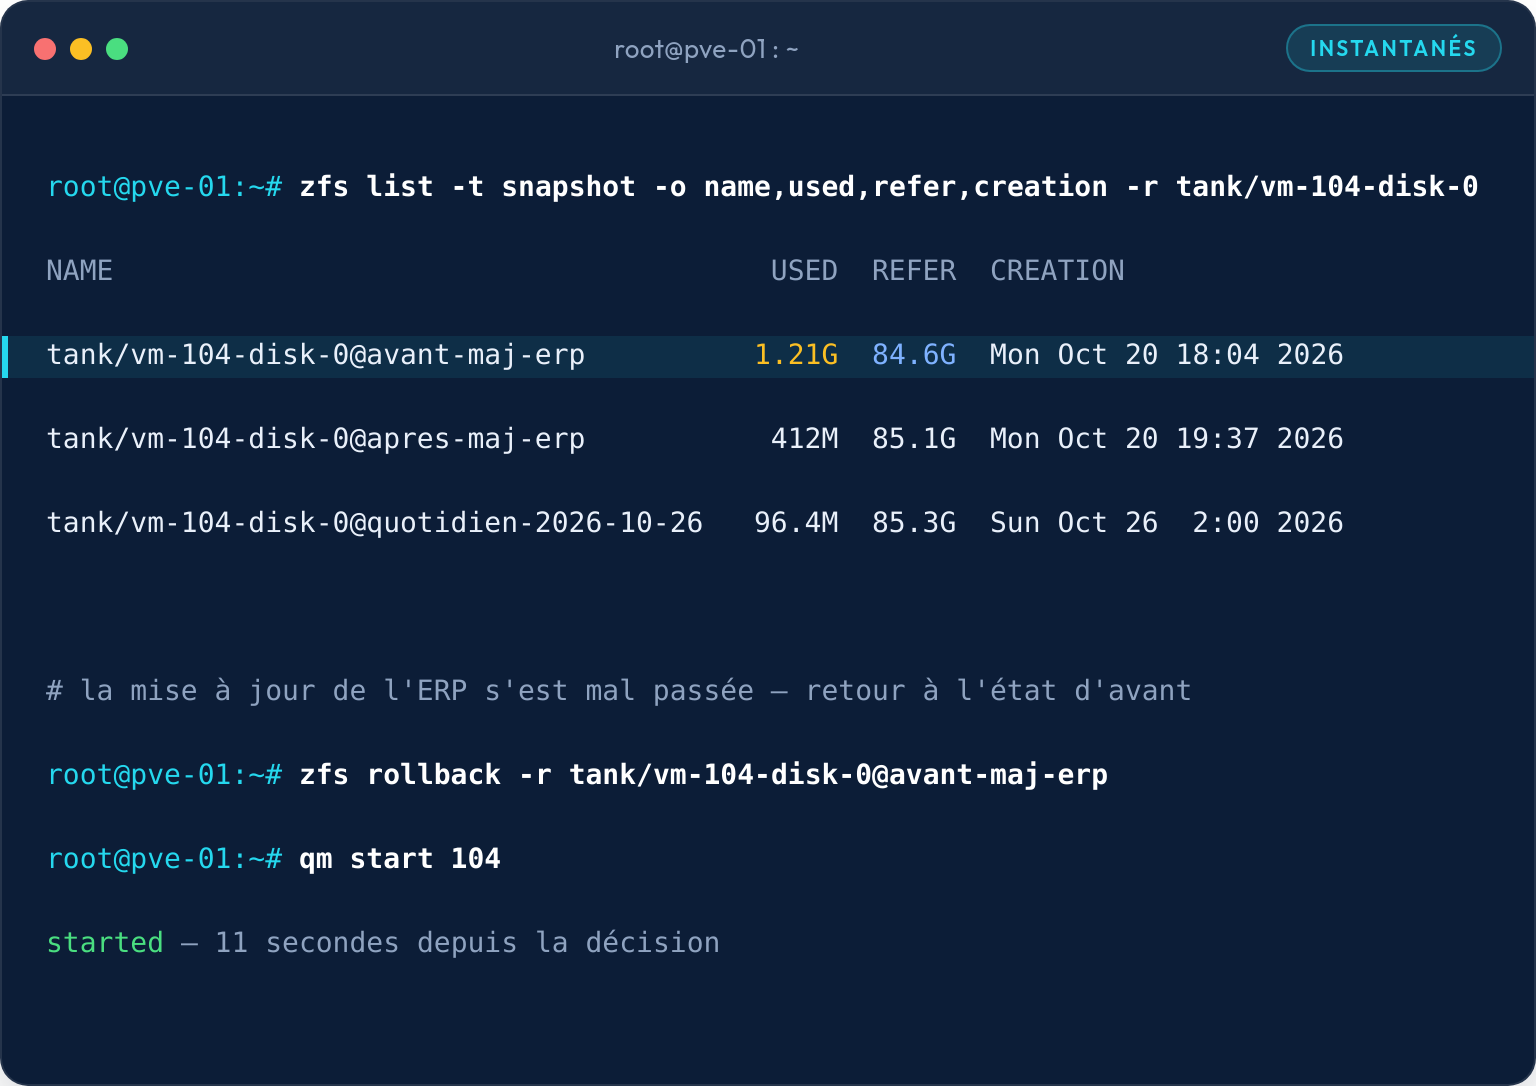
USED est l’espace réellement consommé ; REFER, ce que l’instantané donne à voir.En pratique, cela signifie qu’une mise à jour applicative risquée devient réversible en quelques secondes, et qu’un retour arrière ne se discute plus : il s’exécute. Cette capacité modifie l’organisation du travail autant que la technique — on ose intervenir en journée sur des systèmes que l’on n’aurait touchés qu’un dimanche soir.
Avec une réserve, et elle est importante : un instantané vit sur le même pool que la donnée qu’il protège. Il couvre l’erreur humaine et la mise à jour ratée. Il ne couvre ni l’incendie, ni le chiffrement par un rançongiciel qui aurait obtenu la main sur l’hyperviseur. C’est un filet, pas une sauvegarde.
Répliquer sans tout recopier
zfs send et zfs receive transmettent la différence entre deux instantanés vers un autre hôte. Sur la machine de l’exemple précédent, cela représente 96,4 Mo échangés là où une recopie complète en aurait déplacé 85,3 Go.
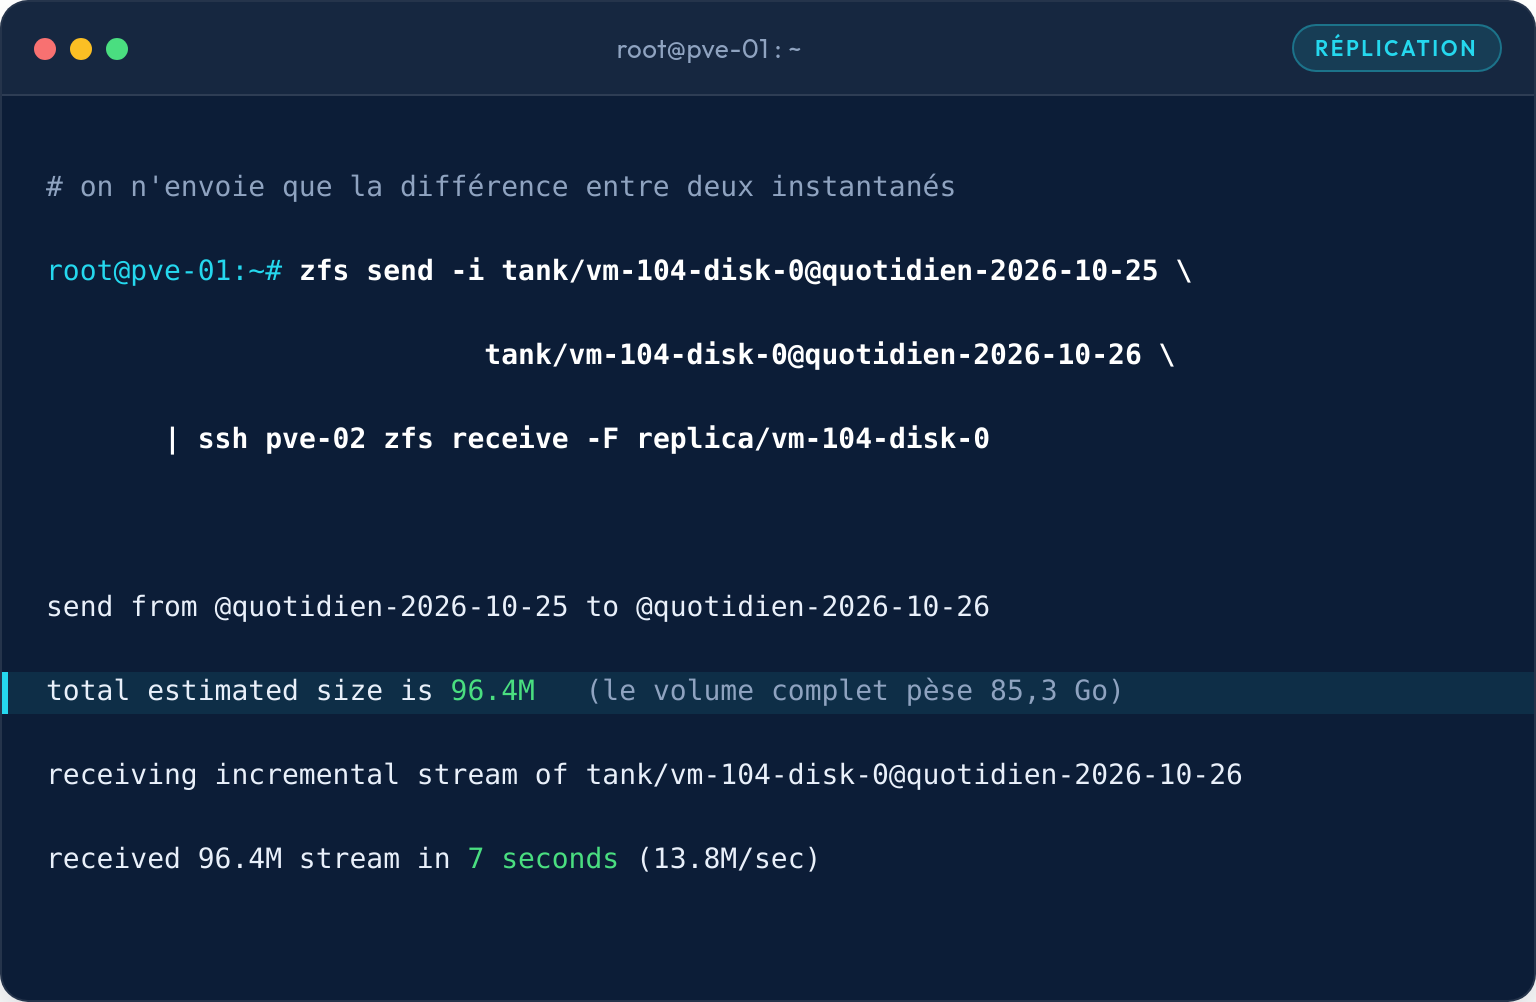
C’est ce qui rend tenable une réplication fréquente entre deux sites reliés par un lien ordinaire. Là encore, une précision honnête : une réplique n’est pas davantage une sauvegarde. Elle recopie fidèlement ce qu’on lui envoie, y compris une suppression et y compris un chiffrement. La chaîne de sauvegarde est un sujet distinct, que nous traitons dans une sauvegarde non testée n’est pas une sauvegarde.
Ce que ça coûte, et qu’on oublie de dire
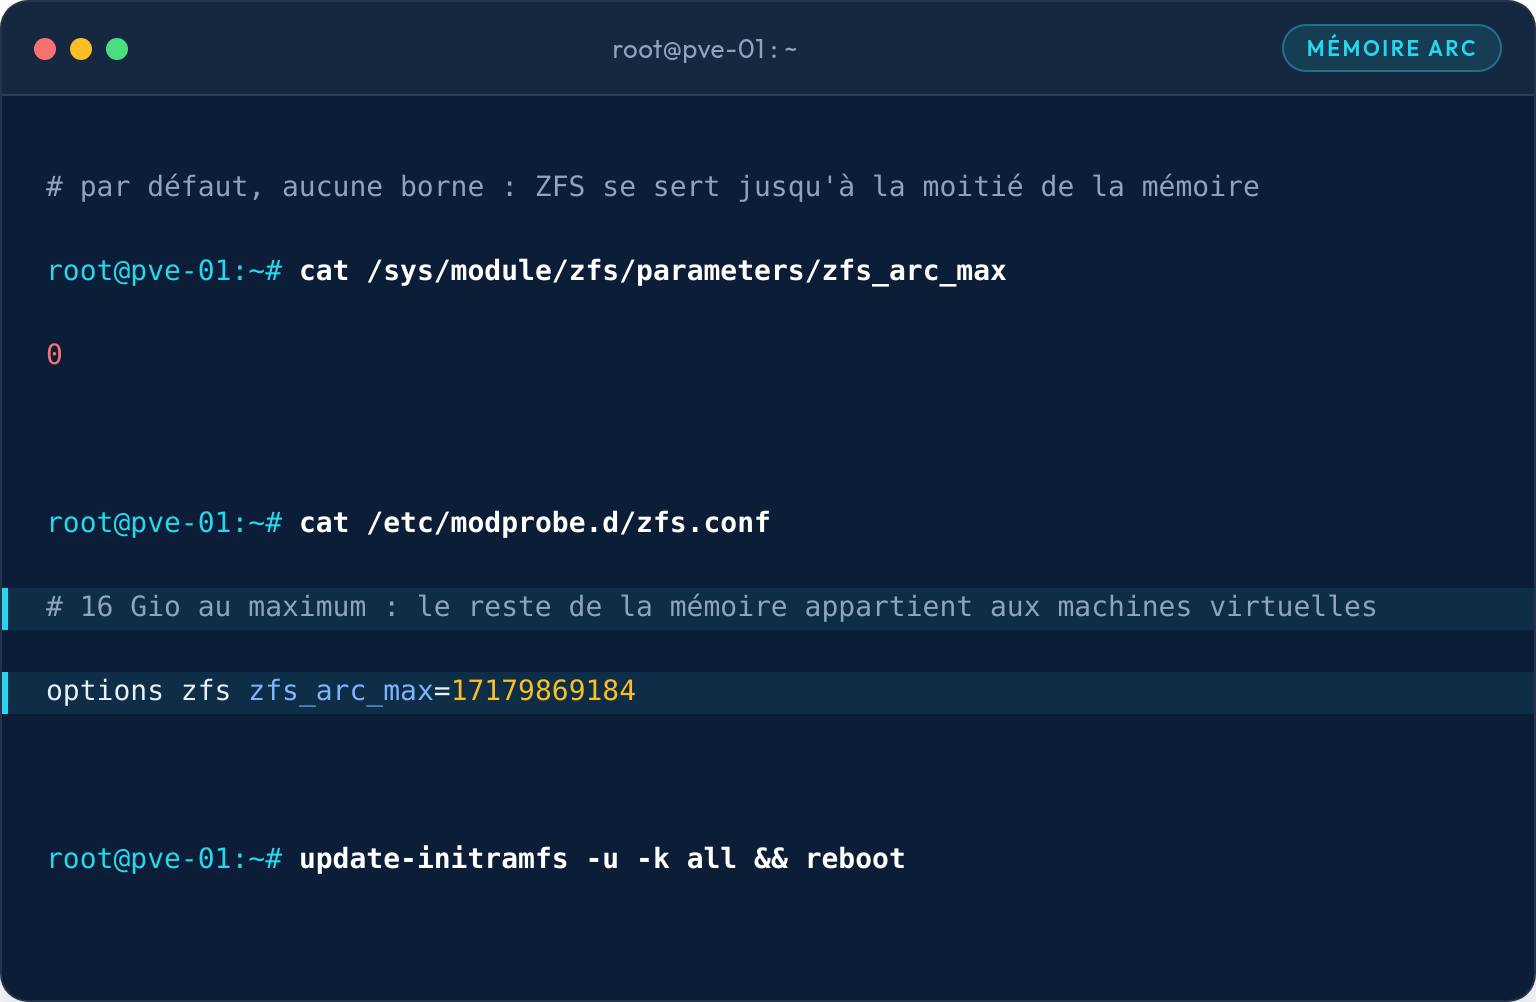
- De la mémoire. Le cache ARC est vorace par conception. Sur un hôte de virtualisation, il faut lui réserver sa part et la borner explicitement, sinon la mémoire manquera aux machines virtuelles.
- Une topologie à réfléchir avant. La disposition du pool se décide au début. Se tromper de structure coûte une migration de données, pas une commande.
- Des disques adaptés. Sur des charges d’écriture synchrone, un SSD sans protection contre les coupures d’alimentation transforme un choix réputé sûr en performance médiocre.
- Une compétence. ZFS pardonne mal l’approximation. Il faut savoir lire un
zpool statuset comprendre ce qu’implique un pool dégradé.
Le premier point est celui qui surprend le plus souvent, et c’est aussi le seul qui se règle en trois lignes. Par défaut, le paramètre n’est pas borné : ZFS se sert jusqu’à la moitié de la mémoire de l’hôte, et le jour où les machines virtuelles en réclament, l’arbitrage n’a rien d’instantané.
Pourquoi Proxmox VE plutôt qu’un hyperviseur propriétaire
Parce que la pile est lisible et administrable jusqu’en bas : ZFS, KVM, LXC, un pare-feu intégré, et une intégration native avec Proxmox Backup Server. Nous savons ce qui tourne sur nos hôtes, nous pouvons le diagnostiquer sans dépendre du calendrier de support d’un éditeur, et le modèle de licence ne se renégocie pas tous les dix-huit mois.
Ce n’est pas une critique des solutions propriétaires, qui restent pertinentes dans d’autres contextes. C’est un choix cohérent avec notre métier : nous vendons de l’exploitation, donc nous voulons des systèmes que nous pouvons réellement exploiter.
Si vous reprenez une infrastructure existante ou que vous envisagez ce socle, c’est le sujet de notre page Infrastructures & cloud privé.